深入探究 malloc/free
深入探究 malloc/free 原理及实现
一、概述
现代计算机程序大多都运行在操作系统之上,内存管理是计算机软件编码中很重要的基础领域之一
需要实现给程序分配足够的内存来处理数据、在适当的时候收回分配出去的内存
本文主要讨论基于 x64 Linux glibc 的 malloc 和 free
二、基础知识
1. 内存布局
进程在内存中布局常见的有:代码段(text)、数据段(data)、bss 段、栈(stack)、堆(heap)等等
下图分别是 x86 和 x64 下 Linux 进程内存布局:
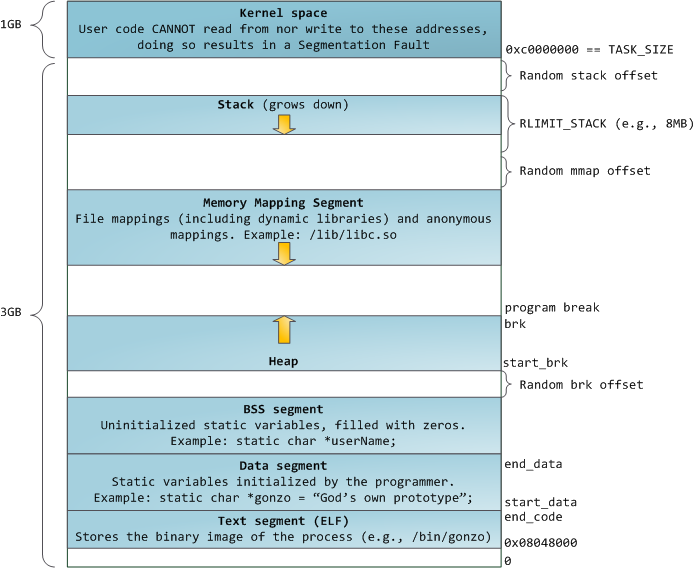
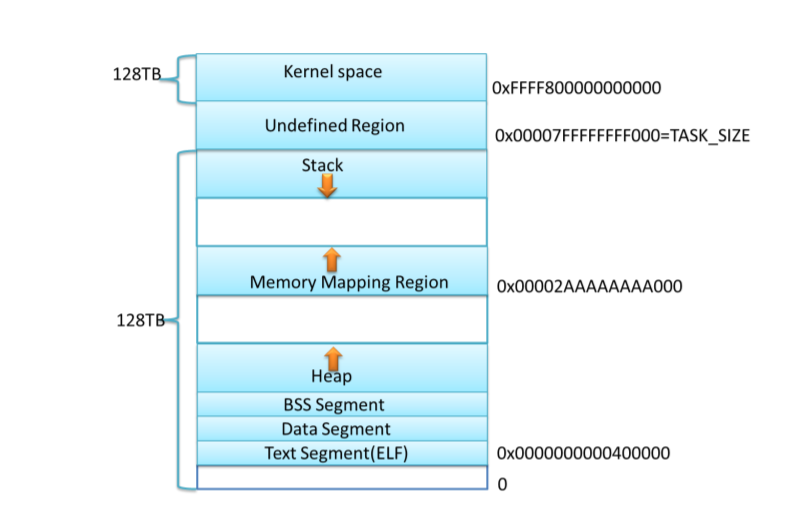
当前内核默认配置下,x64 的内存布局进程的栈和 mmap 映射区域并不是从一个固定地址开始,并且每次启动时的值都 不一样,这是程序在启动时随机改变这些值的设置,使得使用缓冲区溢出进行攻击更加困难
2. Linux 系统调用
上节提到的 heap 和 mmap 映射区域是可以提供给用户程序使用的虚拟内存空间 ,对于 heap 的操作,Linux 提供了 brk() 系统调用,C 运行时库提供了 sbrk() 函数;对于 mmap 映射区域的操作,Linux 提供了 mmap() 和 munmap() 系统调用
brk/sbrk
调用 brk() 可以改变 program break 的位置,也就是未初始化数据段(bss段)之后的第一个位置
增加 program break 相当于分配了内存,减小 program break 相当于释放了内存
|
内存的延迟分配:在 program break 的位置抬升后,程序可以访问新分配区域内的任何内存地址,而此时物理内存页尚未分配。内核会在进程首次试图访问这些虚拟内存地址时自动分配新的物理内存页
内核数据结构 mm_struct 中 start_brk 是进程动态内存分配起始地址(堆的起始地址),brk 是动态内存分配当前的终止地址
mmap
mmap() 将一个文件或者其它文件对象(比如 device)映射进内存
|
参数介绍:
addr:映射区的开始地址,如果addr是NULL,内核选择一个页对齐的位置创建映射区length:映射区的长度,必须大于 0prot:描述了映射区内存保护标志,不能与文件的打开模式冲突,可选有PROT_EXEC,PROT_READ,PROT_WRITE,PROT_NONE等等- flags:指定映射对象的类型,映射选项和映射页是否可以共享,以下按位组合:
MAP_FIXED使用指定的映射起始地址,如果由addr和length参数指定的内存区域重叠于现存的映射空间,重叠部分将会被丢弃。如果指定的起始地址不可用,操作将会失败。并且起始地址必须落在页的边界上MAP_PRIVATE建立一个写入时拷贝的私有映射。内存区域的写入不会影响到原文件。 这个标志和以上标志是互斥的MAP_NORESERVE不要为映射区保留 swap 空间,如果不保留 swap 空间,如果没有可用的物理内存,则在写入时收到SIGSEGV信号MAP_ANONYMOUS匿名映射,映射区不与任何文件关联
fd:有效的文件描述符,如果MAP_ANONYMOUS被设定,为了兼容问题,其值应为-1offset:被映射对象内容的起点
3. 内存管理相关
当不知道程序的每个部分将需要多少内存时,系统内存空间有限,而内存需求又是变化的, 这时就需要内存管理程序来负责分配和回收内存
内存管理的方法:
C-style 的内存管理程序:主要使用
malloc/free来分配和释放内存内存池(Memory Pool):内存池是一种半内存管理方法。这些程序会经历一些特定的阶段,而且每个阶段中都有分配给进程的特定阶段的内存。将整个过程拆分成几个阶段,每个阶段都有自己的内存池,在结束每个阶段时,一次释放所有内存
优点:
- 内存的分配和回收更快,都可以 O(1) 的时间完成
- 可以预先分配错误处理池,以便程序在内存被耗尽时可以恢复
缺点:
- 不能与第三方库很好的合作
- 如果程序结构变化,可能不得不修改内存池,导致内存管理模块得重新设计
- 设计时,需要按照程序需求来做调整,才能保证时间和空间效率
引用计数(Reference Count):
在引用计数中,所有共享的数据结构都有一个域来包含当前活动“引用”结构的次数。当向一个程序传递一个指向某个数据结构指针时,该程序会将引用计数增加 1 当进程完成对它的使用后,该程序就会将引用计数减少 1。结束这个动作之后,它还会检查计数是否已经减到零。如果是,那么它将释放内存。
优点:实现简单、可以尽快回收不再使用的内存、清晰的标明每个对象的生存周期
缺点:引用计数占据了一定的空间、频繁更新引用计数带来的效率问题、循环引用问题导致使用比较麻烦
垃圾回收(Garbage Collection):
全自动地检测并移除不再使用的数据对象。垃圾收集器通常会在当可用内存减少到少于一个具体的阈值时运行。为了有效地管理内存,很多类型的垃圾收集器都需要知道数据结构内部指针的规划。为了正确运行垃圾收集器,它们必须是语言本身的一部分
优点:不必担心内存的双重释放或者对象的生命周期
缺点:大部分无法干涉何时释放内存、多数情况垃圾收集比其他形式的内存管理更慢、垃圾收集错误引发的缺陷难于调试
内存管理的设计目标
- 最大化兼容性
- 最大化可移植性
- 浪费最小空间
- 分配释放内存速度
- 可通过参数以适应不同的情况
- 最大化局部性
- 最大化调试功能
- 最大化适应性,适应多种情况
- 支持多线程的能力
上述的很多指标是互相冲突的,需要在不同的策略上进行权衡,来更好的满足本身的需求
4. 内存分配策略对比
GNU malloc:GNU malloc 继承自 ptmalloc(pthread malloc),ptmalloc 继承自 Doug Lea Malloc。
Hoard:目标是使内存分配在多线程环境中进行得非常快。因此,它的构造以锁的使用为中心,从而使所有进程不必等待分配内存。它可以显著地加快那些进行很多分配和回收的多线程进程的速度
jemalloc:原先被使用做 FreeBSD libc 的分配器,现在 Facebook、Firefox 中使用了 jemalloc,主要特点是每个线程绑定到一个独立的 arena 上来避免锁竞争,不过某个线程占用大量空间会导致内存空间的浪费。还有可以从预先确实大小的对象构成的池中分配对象。有一些用于对象大小的 size_class
TCMalloc:Thread-Caching Malloc,是Google 开源工具 google-perftools 中的成员,与 GNU malloc 相比 TCMalloc 内存的分配上效率和速度要高得多,TCMalloc 有比较高的空间利用率,只额外花费 1%的空间。 尽量避免加锁(一次加锁解锁约浪费 100ns),使用更高效的 spinlock,采用更合理的粒度,小块内存和大块内存分配采取不同的策略
| 策略 | 分配速度 | 回收速度 | 缓存局部性 | 易用性 | 通用性 | SMP 线程友好度 |
|---|---|---|---|---|---|---|
GNU malloc |
中 | 快 | 中 | 容易 | 高 | 中 |
| Hoard | 中 | 中 | 中 | 容易 | 高 | 高 |
TCMalloc |
快 | 快 | 中 | 容易 | 高 | 高 |
Reference Count |
N/A | N/A | 极好 | 中 | 中 | 依赖于 malloc 实现 |
| Pool | 中 | 非常快 | 极好 | 中 | 中 | 依赖于 malloc 实现 |
| Garbage collection | 中(当回收时速度慢) | 中 | 差 | 中 | 中 | N/A |
三、ptmalloc
1. 概述
Linux 中早期的 malloc 由 Doug Lea 实现,存在的问题是多线程情况下如何保证分配和回收的正确和高效。Wolfram Gloger 在 Doug Lea 的基础上改进,使得 glibc 的 malloc 可以支持多线程。在 glibc 中,集成了 ptmalloc2 的改进版本(见 glibc 中 malloc 的源码,比如我目前正在使用 Ubuntu1804 中 带有的 glibc2.27 malloc),ptmalloc2 的性能比 ptmalloc3 略高一点
ptmalloc2 的设计理念比较折衷,不是最快的、最节省空间的,也不是移植性和可调试性最好的,但是它对这些因素进行了折衷,形成了 malloc 密集型程序的通用分配器
算法的主要特性是:
- 对于小的(默认
<= 64 bytes)内存申请,使用 cache allocator,维护着一个快速回收 chunks 的内存池 - 对于大的(
>= 512 bytes) 内存申请,使用 pure best-fit allocator,通常由 FIFO(也就是最近最少使用,LRU)来决定 - 在上述两者之间的内存申请,对上述两种内存分配方式进行结合,尽可能得满足两种请求的需要
- 对于非常大的内存申请(默认
>= 128KB),使用mmap
因为大块内存很可能会有较长的生命周期,使用 brk 分配大块内存将更可能产生内存碎片(因为不释放顶部的内存块则无法释放堆大小)。
对空闲的小内存块只会在 malloc 和 free 的时候进行合并,而且可能会放回到内存池中,收缩堆的条件是堆顶的空闲的块加上能合并的 chunk 的大小大于 64 KB 才可能进行堆收缩
需要长期存储的程序不适应使用 ptmalloc 来管理内存
2. 相关数据结构
(1) arena
在最初的实现(Doug Lea)中,只有一个主分配区(main arena),每次分配内存都必须对 main arena 进行加锁,完成分配后释放锁。在多线程的环境下,锁争用严重影响了 malloc 的分配效率。Wolfram Gloger 增加了 non main arena,main arena 和 non main arena 使用环形链表进行管理,每个分配区使用 mutex 使得该分配区的访问互斥
每个进程有一个 main arena,可能有多个non main arena,根据对分配区的争用情况动态增加(不能减少) non main arena 的数量,main arena 可以访问进程的 heap 和 mmap 区域,non arena 只能访问 mmap 区域,non main arena 每次使用 mmap 向操作系统”批发” HEAP_MAX_SIZE (default 1 MB in 32 bit, 64 MB in 64 bit) 大小的虚拟内存,当向 non main arena 请求内存分配时会切割成小块”零售”出去
main arena 可以访问 heap 区,如果用户不调用 brk() 和 sbrk(),malloc 就可以保证分配到连续的虚拟内存。brk() 比起 mmap() 要相对简单高效些。
如果主分配区的内存是通过 mmap() 向系统分配的,当 free 该内存时,主分配区会直接调用 munmap() 将该内存归还给系统
当某一线程需要调用 malloc() 分配内存空间时,该线程先查看线程私有变量中是否已经存在一个分配区,如果存在, 尝试对该分配区加锁,如果加锁成功,使用该分配区分配内存,如果失败, 该线程搜索循环链表试图获得一个没有加锁的分配区。如果所有的分配区都已经加锁,那么 malloc() 会开辟一个新的分配区, 把该分配区加入到全局分配区循环链表并加锁,然后使用该分配区进行分配内存操作。在释放操作中,线程同样试图获得待释放内存块所在分配区的锁,如果该分配区正在被别的线程使用,则需要等待直到其他线程释放该分配区的互斥锁之后才可以进行释放操作
申请小块内存时会产生很多内存碎片,ptmalloc 在整理时也需要对分配区做加锁操作。每个加锁操作大概需要 5~10 个 CPU 指令,而且程序线程很多的情况下,锁等待的时间就会延长,导致 malloc 性能下降。一次加锁操作需要消耗 100ns 左右,正是锁的缘故,导致 ptmalloc 在多线程竞争情况下性能远远落后于 tcmalloc。最新版的 ptmalloc 对锁进行了优化,加入了 PER_THREAD 和 ATOMIC_FASTBINS 优化,但默认编译不会启用该优化, 这两个对锁的优化应该能够提升多线程内存的分配的效率
(2) chunk
不管内存是在哪里被分配的,用什么方法分配,用户请求分配的空间在 ptmalloc 中都使用一个 chunk 来表示。用户调用 free() 函数释放掉的内存也并不是立即就归还给操作系统,相反,它们也会被表示为一个 chunk,ptmalloc 使用特定的数据结构来管理这些空闲的 chunk
注:下图来自于 glibc2.27 malloc
使用中的 chunk:
chunk-> +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+ |
P 表示上一个块是否在使用,如果 P 为 0 表示上一个块为空闲,prev_size 才有效。可以使用 prev_size 找到前一个 chunk 的开始地址。
M 表示 chunk 是从哪个区域分配获得的虚拟地址,M 为 1 表示该 chunk 从 mmap 中分配的,否则是从 heap 中分配的
A 表示 chunk 属于 main arena 还是 non main arena,如果是 non main arena 的话,A为 1,否则为 0
空的 chunk:
chunk-> +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+ |
chunk 中的空间复用:
当一个 chunk 处于使用状态时, 它的下一个 chunk 的 prev_size 域肯定是无效的。 所以实际上, 这个空间也可以被当前 chunk 使用
(3) bins
bins 是空闲 chunk 的容器,是一个 bins header 的数组。用户 free 掉的内存并不是都会马上归还操作系统,ptmalloc 会统一管理 heap 和 mmap 映射区域中的空闲的 chunk,当用户进行下一次分配请求时, ptmalloc 会首先试图在空闲的chunk 中挑选一块给用户,这样就避免了频繁的系统调用,降低了内存分配的开销
将相似大小的 chunk 用双向链表链接起来,这样的一个链表被称为一个 bin。 ptmalloc 一共维护了 128 个 bins
index 0 |
待续…